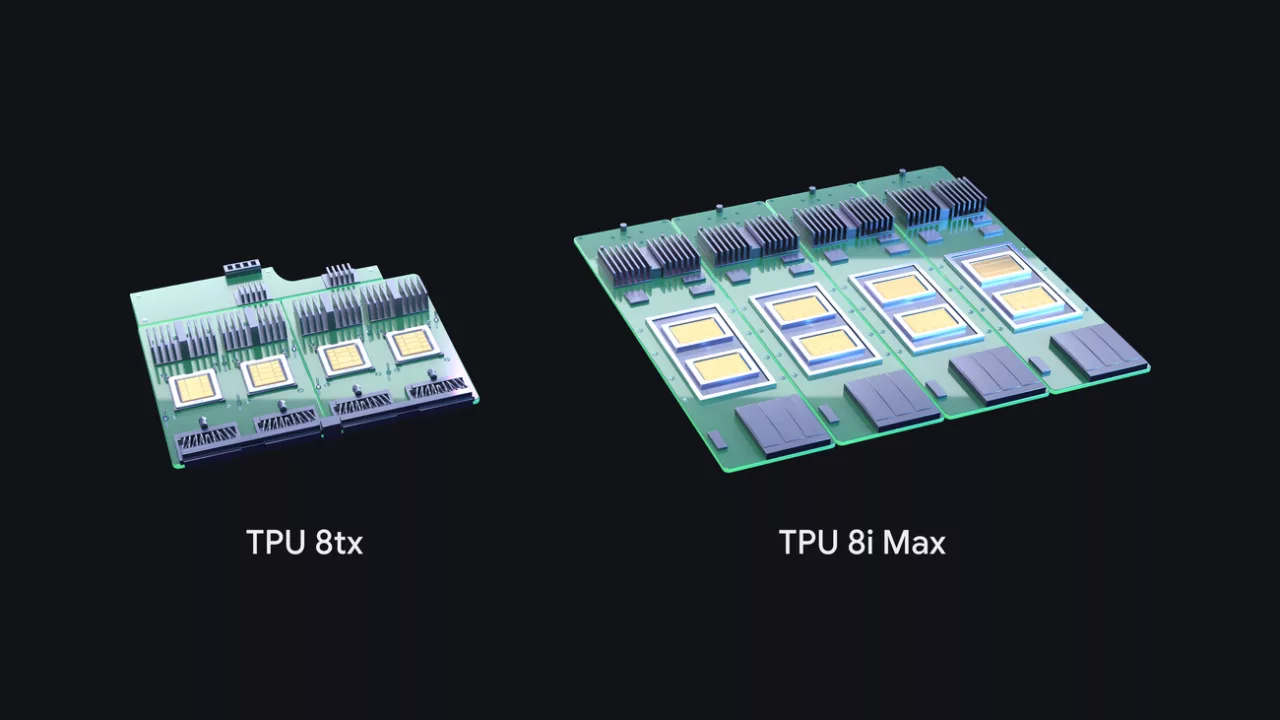
Google a présenté le 9 novembre 2026 deux nouvelles puces d’intelligence artificielle pour ses centres de données. Le TPU 8tx traite des données sensibles sans les exposer, tandis que le TPU 8i Max réunit deux puces en une pour les très gros volumes de mémoire. Les entreprises clientes de Google Cloud disposeront donc de nouvelles options pour faire tourner leurs agents IA sans passer par les cartes graphiques de Nvidia.
Qu’est-ce qu’un TPU, et pourquoi Google en fabrique-t-il ?
Un TPU (Tensor Processing Unit) est une puce conçue par Google pour une seule mission : les calculs de l’intelligence artificielle. Un processeur classique ressemble à un couteau suisse qui sait tout faire, le TPU à un outil spécialisé qui ne fait qu’une chose, mais plus vite et en consommant moins.
Google a dessiné le premier il y a plus de dix ans, à l’origine pour la reconnaissance vocale et la traduction. Vous ne trouverez pas ces puces en magasin. Elles sont louées aux entreprises via Google Cloud. Le groupe revendique près de 100 clients : laboratoires d’IA, sociétés de trading, enseignes de distribution et universités.
Que change le TPU 8tx pour les données sensibles ?
Le TPU 8tx protège les données pendant qu’elles sont traitées, et pas seulement lorsqu’elles sont stockées ou transmises. On parle d’informatique confidentielle. Imaginez un coffre-fort dans lequel les calculs se font porte fermée, sans que l’hébergeur puisse regarder à l’intérieur.
Les données de l’entreprise restent isolées au niveau du matériel. Les « poids » du modèle aussi, ces paramètres appris pendant l’entraînement qui font sa valeur. La puce reprend le silicium du TPU 8t, la version prévue pour l’entraînement, et s’appuie sur des processeurs AMD EPYC de cinquième génération pour piloter l’ensemble.
Elle emprunte aussi au TPU 8i son réseau interne à faible latence, baptisé Boardfly. Google annonce une latence jusqu’à deux fois plus faible que celle du TPU 8t, avec une perte de performance qu’il dit quasi nulle. Le groupe vise surtout les entreprises réglementées et les administrations. Elles peuvent ainsi adapter un modèle à leurs propres documents sans les faire sortir d’un environnement protégé.
Le TPU 8i Max, deux puces dans un même boîtier
Le TPU 8i Max assemble deux puces TPU 8i sur un seul support. Par rapport au TPU 8i présenté en avril, il double la puissance de calcul et la mémoire SRAM logée dans la puce. La bande passante de la mémoire HBM, une mémoire très rapide placée juste à côté du processeur, double elle aussi.
Le tout tient dans le même encombrement en baie, donc plus de calcul au mètre carré et par watt. Google cible ce qu’il appelle le « mur de la mémoire » : des travaux où l’IA doit garder en tête une masse énorme d’informations, comme plusieurs agents qui épluchent ensemble le code d’un logiciel ou l’analyse de plusieurs heures de vidéo.
Pourquoi Google sort-il quatre TPU en une seule année ?
Google veut une puce adaptée à chaque étape de la vie d’un agent IA, plutôt qu’une puce généraliste. En avril 2026, lors de sa conférence Google Cloud Next, le groupe avait déjà lancé le TPU 8t pour l’entraînement et le TPU 8i pour le raisonnement en temps réel.
D’après Google, le premier entraîne les modèles jusqu’à 2,7 fois plus vite que la génération précédente. Le second améliore de 80% le rapport performance-prix de l’inférence, autrement dit l’utilisation quotidienne d’un modèle déjà entraîné. C’est la première fois que Google sort quatre systèmes TPU la même année. Le groupe teste même des calculs d’IA en orbite avec le Project Suncatcher.
Ces puces IA Google concurrencent directement les cartes graphiques de Nvidia, qui dominent le marché. L’annonce tombe pendant une période agitée pour Nvidia, marquée par l’enquête interne visant Jensen Huang. Le 9 novembre, l’action AMD a gagné environ 13% et celle d’Alphabet un peu plus de 3%, tandis que Nvidia reculait de plus de 4%.
Des logiciels pour économiser du calcul
Les logiciels annoncés en même temps réduisent le calcul gaspillé et facilitent le passage des développeurs vers les TPU. Le service Agent Compute Engine suspend automatiquement un agent IA quand il attend une réponse (une base de données, un outil extérieur, la validation d’un humain), puis le relance. C’est un peu comme couper le moteur au feu rouge.
Publié en open source, TPU Sync organise la mémoire en plusieurs étages, et Google affirme qu’il réduit de plus de 90% le délai avant le premier mot généré. Une suite d’outils en préversion se branche enfin sur des assistants de programmation comme Claude Code, Cursor ou Google Antigravity.
Quand pourra-t-on utiliser ces puces en France ?
Google n’a communiqué ni date de disponibilité ni tarif pour le TPU 8tx et le TPU 8i Max. Comme les générations précédentes, ils seront loués via Google Cloud, sans précision à ce stade sur les régions concernées. Si vous utilisez Gemini au quotidien, rien ne change directement pour vous. Ces puces s’adressent aux entreprises qui font tourner leurs propres modèles.
Ce qu’il faut retenir :
- TPU 8tx : calcul confidentiel, silicium du TPU 8t, processeurs AMD EPYC, latence jusqu’à deux fois plus faible ;
- TPU 8i Max : deux TPU 8i dans un boîtier, calcul, SRAM et bande passante HBM doublés ;
- prix et date de sortie : pas encore communiqués par Google.